Python vs. PL/SQL vs. Shell: quando a escolha técnica impacta o negócio
Uma comparação técnica de coleções, processamento em lote e decisões de arquitetura — com critérios de performance, operação e gestão de TI.
Introdução
Ao longo da minha trajetória trabalhando com Oracle Database, administração de ambientes críticos e plataformas de dados, percebi que muitos problemas técnicos não estão necessariamente relacionados à tecnologia utilizada, mas à forma como escolhemos utilizá-la.
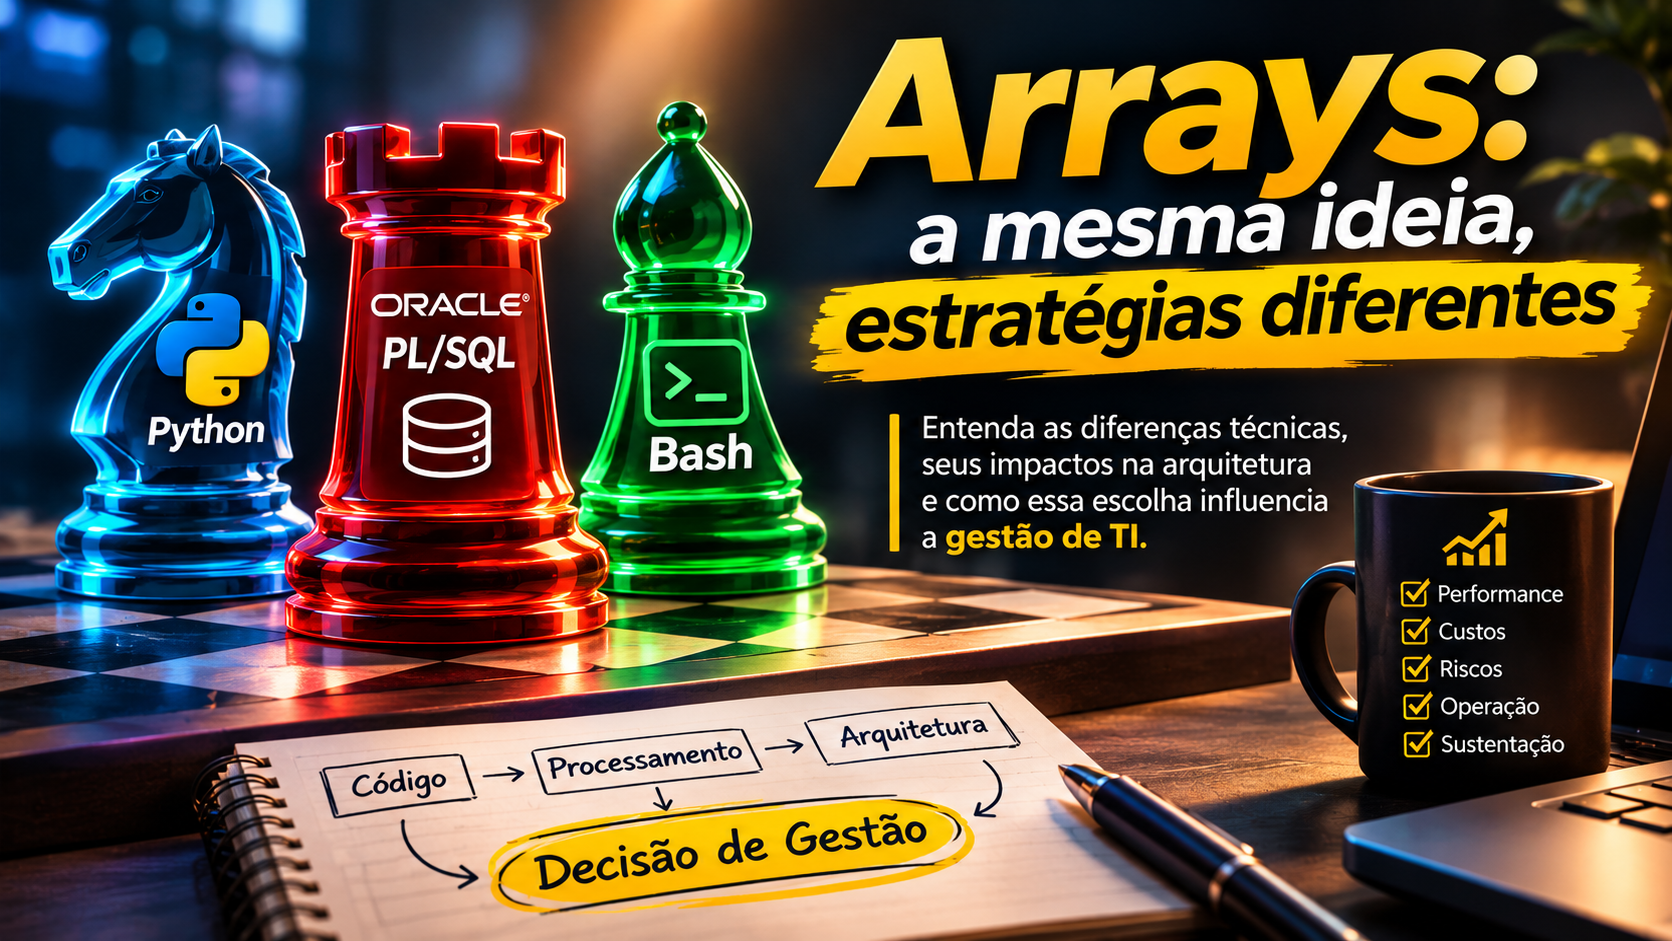
Um exemplo interessante são os arrays. Python utiliza listas e outras estruturas; PL/SQL dispõe de VARRAY, nested tables e associative arrays; e Bash oferece arrays para automações. Todas permitem organizar e manipular múltiplos valores, mas suas regras e seus ambientes de execução são diferentes.
A tese deste artigo: a tecnologia define como podemos processar dados; a arquitetura determina onde faz sentido processá-los; e a gestão deve garantir que essa escolha seja eficiente, segura e sustentável.
Vamos partir do mesmo conjunto de identificadores de discos — sdb, sdc, sdd, sde e sdf — e avançar da sintaxe para decisões reais de engenharia.
1. O que é um array — e o que não é?
No Python, list é uma sequência mutável e dinâmica, que pode misturar tipos. tuple é uma sequência imutável; dict associa chaves a valores; array.array oferece armazenamento tipado; e NumPy fornece arrays multidimensionais especializados (biblioteca externa). Essas estruturas não são intercambiáveis.
No PL/SQL, collection engloba VARRAY, nested table e associative array. Cada tipo tem semântica própria de limites, índices e interação com SQL.
No Bash, arrays indexados e associativos armazenam valores textuais usados em automações. Não são equivalentes a tabelas relacionais do Oracle.
2. Python: lista dinâmica e índice zero
discos = ["sdb", "sdc", "sdd", "sde", "sdf"]
print(discos[0])
print(len(discos))
discos.append("sdg")
for indice, disco in enumerate(discos):
    print(indice, disco)
Saída esperada:
sdb
5
0 sdb
1 sdc
2 sdd
3 sde
4 sdf
5 sdg
A lista cresce sem limite máximo declarado (sujeita à memória disponível). O índice inicial é zero; acessar uma posição inexistente provoca IndexError.
Para demonstrar a diferença entre lista e array tipado:
from array import array
numeros = array("i", [10, 20, 30])
print(numeros[0])  # 10
# numeros.append("texto")  # TypeError: valor incompatível
3. PL/SQL: VARRAY com tipo e capacidade definidos
SET SERVEROUTPUT ON
DECLARE
    TYPE t_discos IS VARRAY(10) OF VARCHAR2(10);
    v_discos t_discos := t_discos('sdb','sdc','sdd','sde','sdf');
BEGIN
    DBMS_OUTPUT.PUT_LINE(v_discos(1));
    DBMS_OUTPUT.PUT_LINE(v_discos.COUNT);
    v_discos.EXTEND;
    v_discos(v_discos.LAST) := 'sdg';
    FOR i IN 1 .. v_discos.COUNT LOOP
        DBMS_OUTPUT.PUT_LINE(i || ' ' || v_discos(i));
    END LOOP;
END;
/
Saída esperada:
sdb
5
1 sdb
2 sdc
3 sdd
4 sde
5 sdf
6 sdg
PL/SQL procedure successfully completed.
O VARRAY inicia em 1 e respeita o limite declarado de 10 elementos. Não se pode acrescentar indefinidamente com EXTEND.
Armadilha de indexação: Python x VARRAY
Em Python, discos[0] acessa o primeiro elemento. No VARRAY PL/SQL, v_discos(0) não é um índice válido e gera ORA-06532: Subscript outside of limit para a coleção inicializada acima.
Atenção: isso não significa que todo array PL/SQL começa em 1. Associative arrays indexados por PLS_INTEGER podem utilizar 0 e até índices negativos.
4. Outras coleções PL/SQL: índices esparsos e semântica
Associative array
SET SERVEROUTPUT ON
DECLARE
    TYPE t_discos IS TABLE OF VARCHAR2(10) INDEX BY PLS_INTEGER;
    v_discos t_discos;
    i PLS_INTEGER;
BEGIN
    v_discos(-1) := 'sdb';
    v_discos(0) := 'sdc';
    v_discos(30) := 'sdd';
    i := v_discos.FIRST;
    WHILE i IS NOT NULL LOOP
        DBMS_OUTPUT.PUT_LINE(i || ' ' || v_discos(i));
        i := v_discos.NEXT(i);
    END LOOP;
END;
/
Saída esperada:
-1 sdb
0 sdc
30 sdd
A navegação com FIRST e NEXT é apropriada quando os índices não são contíguos.
Nested table
SET SERVEROUTPUT ON
DECLARE
    TYPE t_discos IS TABLE OF VARCHAR2(10);
    v_discos t_discos := t_discos('sdb','sdc','sdd');
    i PLS_INTEGER;
BEGIN
    v_discos.DELETE(2);
    i := v_discos.FIRST;
    WHILE i IS NOT NULL LOOP
        DBMS_OUTPUT.PUT_LINE(i || ' ' || v_discos(i));
        i := v_discos.NEXT(i);
    END LOOP;
END;
/
Collection não é tabela física
Uma collection PL/SQL pode existir somente na memória da sessão ou do bloco. Ela não cria automaticamente uma tabela persistente. Nested tables e VARRAYs definidos como tipos SQL podem participar de operações SQL conforme as regras do Oracle. Associative arrays possuem restrições próprias nessa interface, especialmente quando os tipos são declarados apenas em PL/SQL.
5. Comparação técnica
| Critério | Python list | PL/SQL VARRAY | PL/SQL Nested Table | PL/SQL Associative Array | Bash indexado |
|---|---|---|---|---|---|
| Índice inicial típico | 0 | 1 | 1 | Definido no código | 0 |
| Limite declarado | Não | Sim | Não | Não | Não |
| Índices esparsos | Não | Não | Sim após exclusões | Sim | Sim |
| Tipo dos elementos | Pode ser misto | Declarado | Declarado | Declarado | Texto |
| Aplicação | Aplicações e pipelines | Coleções limitadas | Coleções e integração SQL | Mapas e processamento procedural | Automação operacional |
Critério de engenharia: não escolha a estrutura apenas por familiaridade. Considere tipo de acesso, tamanho, mutabilidade, restrições de memória e integração com o ambiente.
6. Processamento em lote: quando collections deixam de ser apenas didáticas
O maior ganho de uma collection PL/SQL pode estar na interação com SQL. O FORALL permite enviar operações DML em lote ao mecanismo SQL, reduzindo trocas de contexto em comparação com um loop que executa uma instrução DML por iteração. Isso não garante que FORALL seja melhor que uma única instrução SQL em conjunto.
Laboratório isolado (cria tabela de teste):
CREATE TABLE lab_array_lote (
    id NUMBER PRIMARY KEY,
    descricao VARCHAR2(50)
);

DECLARE
    TYPE t_ids IS TABLE OF NUMBER INDEX BY PLS_INTEGER;
    v_ids t_ids;
BEGIN
    FOR i IN 1 .. 1000 LOOP
        v_ids(i) := i;
    END LOOP;

    FORALL i IN INDICES OF v_ids
        INSERT INTO lab_array_lote (id, descricao)
        VALUES (v_ids(i), 'Registro ' || v_ids(i));

    DBMS_OUTPUT.PUT_LINE('Linhas inseridas: ' || SQL%ROWCOUNT);
    ROLLBACK; -- não mantém as linhas do laboratório
END;
/

DROP TABLE lab_array_lote PURGE;
Em Python, python-oracledb disponibiliza cursor.executemany() para enviar operações em lote. Os dois mecanismos não são idênticos: Python executa fora do banco e pode incorrer em custos de rede, enquanto FORALL executa no ambiente PL/SQL. A comparação deve considerar arquitetura e workload.
7. Shell Script: arrays para automação operacional
#!/usr/bin/env bash
discos=("sdb" "sdc" "sdd" "sde" "sdf")
printf 'Primeiro: %s\n' "${discos[0]}"
printf 'Quantidade inicial: %s\n' "${#discos[@]}"
discos+=("sdg")
for indice in "${!discos[@]}"; do
    printf '%s %s\n' "$indice" "${discos[$indice]}"
done
Saída esperada:
Primeiro: sdb
Quantidade inicial: 5
0 sdb
1 sdc
2 sdd
3 sde
4 sdf
5 sdg
Exemplo operacional com lsblk
#!/usr/bin/env bash
mapfile -t discos < <(lsblk -dn -o NAME,TYPE | awk '$2 == "disk" {print $1}')
printf 'Discos detectados: %s\n' "${#discos[@]}"
for disco in "${discos[@]}"; do
    printf '/dev/%s\n' "$disco"
done
Esse script somente lista dispositivos detectados. Não identifica discos livres para ASM, LVM ou uso em produção: é necessário validar multipath, assinaturas, mapeamento e utilização atual.
8. Da sintaxe à arquitetura: onde processar um milhão de registros?
Imagine uma rotina que lê um milhão de linhas no Oracle, aplica transformações e grava resultados. Três papéis podem coexistir:
- Oracle SQL/PL/SQL: filtrar, agregar e atualizar dados próximos ao armazenamento. Preferir SQL em conjunto quando adequado; utilizar
BULK COLLECTeFORALLpara processamento procedural em lote, com controle de memória. - Python: integrar serviços, aplicar bibliotecas especializadas e mover dados quando necessário, usando lotes e observando latência e consumo de memória.
- Bash: iniciar processos, controlar parâmetros, capturar status, registrar logs e integrar o agendamento operacional.
Bash (orquestração e controle)
            |
            v
Python (integração e validação)
            |
            v
Oracle SQL / PL/SQL (processamento próximo aos dados)
            |
            v
Métricas, logs e auditoria
É um fluxo ilustrativo, não uma sequência obrigatória. Às vezes o Python deve apenas disparar uma operação SQL, sem extrair o conjunto inteiro para a aplicação.
Quando uma decisão técnica se torna uma decisão de gestão
Em ambientes corporativos, uma decisão aparentemente simples, como escolher onde processar uma coleção, pode produzir impactos que vão além do código.
Transferir milhões de linhas para Python e depois devolvê-las ao Oracle pode ser necessário por requisitos de integração. Mas, se toda a transformação puder ser resolvida por uma operação SQL eficiente, a movimentação adicional merece ser questionada.
Além do tempo de execução, a liderança técnica precisa considerar consumo de recursos, segurança, mecanismos de recuperação, observabilidade e capacidade da equipe de sustentar a solução.
Uma solução funcional não é necessariamente a solução mais eficiente, econômica ou sustentável para a organização.
9. Matriz de decisão: técnica, arquitetura e gestão
| Dimensão | Pergunta de decisão | Indicador possível |
|---|---|---|
| Performance | Onde o processamento gera menor custo total? | Tempo, throughput, CPU |
| Infraestrutura | É necessário transferir grandes volumes? | Bytes trafegados, memória |
| Resiliência | Como reprocessar após falha? | Tempo de recuperação, falhas |
| Segurança | Onde os dados sensíveis circulam? | Acessos, auditoria, exposição |
| Operação | Como detectar e diagnosticar incidentes? | Logs, alertas, MTTR |
| Pessoas | A equipe consegue manter a solução? | Esforço, dependência, treinamento |
| Custos | Qual o custo por execução? | Consumo e custo estimado |
Essa matriz não escolhe automaticamente a linguagem. Ela estrutura a discussão e permite registrar as razões da decisão.
10. Performance: o que precisamos medir antes de concluir?
Não há benchmark real neste artigo. Para testar desempenho de forma honesta, separe três cenários:
- Manipulação de coleções em memória, sem banco.
- Envio em lote de Python para Oracle com
executemany(). - Processamento dentro do Oracle com SQL em conjunto e, quando apropriado,
BULK COLLECT/FORALL.
Registre versões, volume, tamanho de lote, ambiente, tempo, CPU, memória e tráfego de rede. Não compare um loop Python com uma operação SQL em conjunto como se fossem cargas equivalentes.
Conclusão técnica e gerencial
Arrays e collections em Python, PL/SQL e Bash compartilham um propósito: organizar valores para processamento. Porém, tipagem, indexação, crescimento, acesso e ambiente de execução mudam significativamente.
O conhecimento técnico permite identificar essas diferenças. A visão de arquitetura ajuda a decidir onde cada etapa deve acontecer. A gestão garante que a solução seja observável, segura, economicamente justificável e sustentável pela equipe.
Conhecer uma linguagem permite escrever código. Entender suas características e limitações permite tomar decisões técnicas melhores.
Referências oficiais
- Python — Data Structures
- Python — array
- Oracle Database 19c — PL/SQL Collections and Records
- Oracle Database 19c — Bulk SQL and Bulk Binding
- python-oracledb — Batch Statement Execution
- GNU Bash Manual — Arrays
Exemplos para estudo e laboratório. Saídas ilustram resultados esperados; não representam medições ou execuções verificadas. Teste códigos e permissões em ambientes controlados antes de adaptá-los para produção.
Comments
Join the discussionNo comments yet. Be the first to comment.