Oracle AI Data Platform (AIDP): arquitetura, componentes e quando utiliza-lo
Entenda a arquitetura, os componentes e como avaliar o AIDP frente a outros serviços OCI, Databricks, Snowflake e Microsoft Fabric.
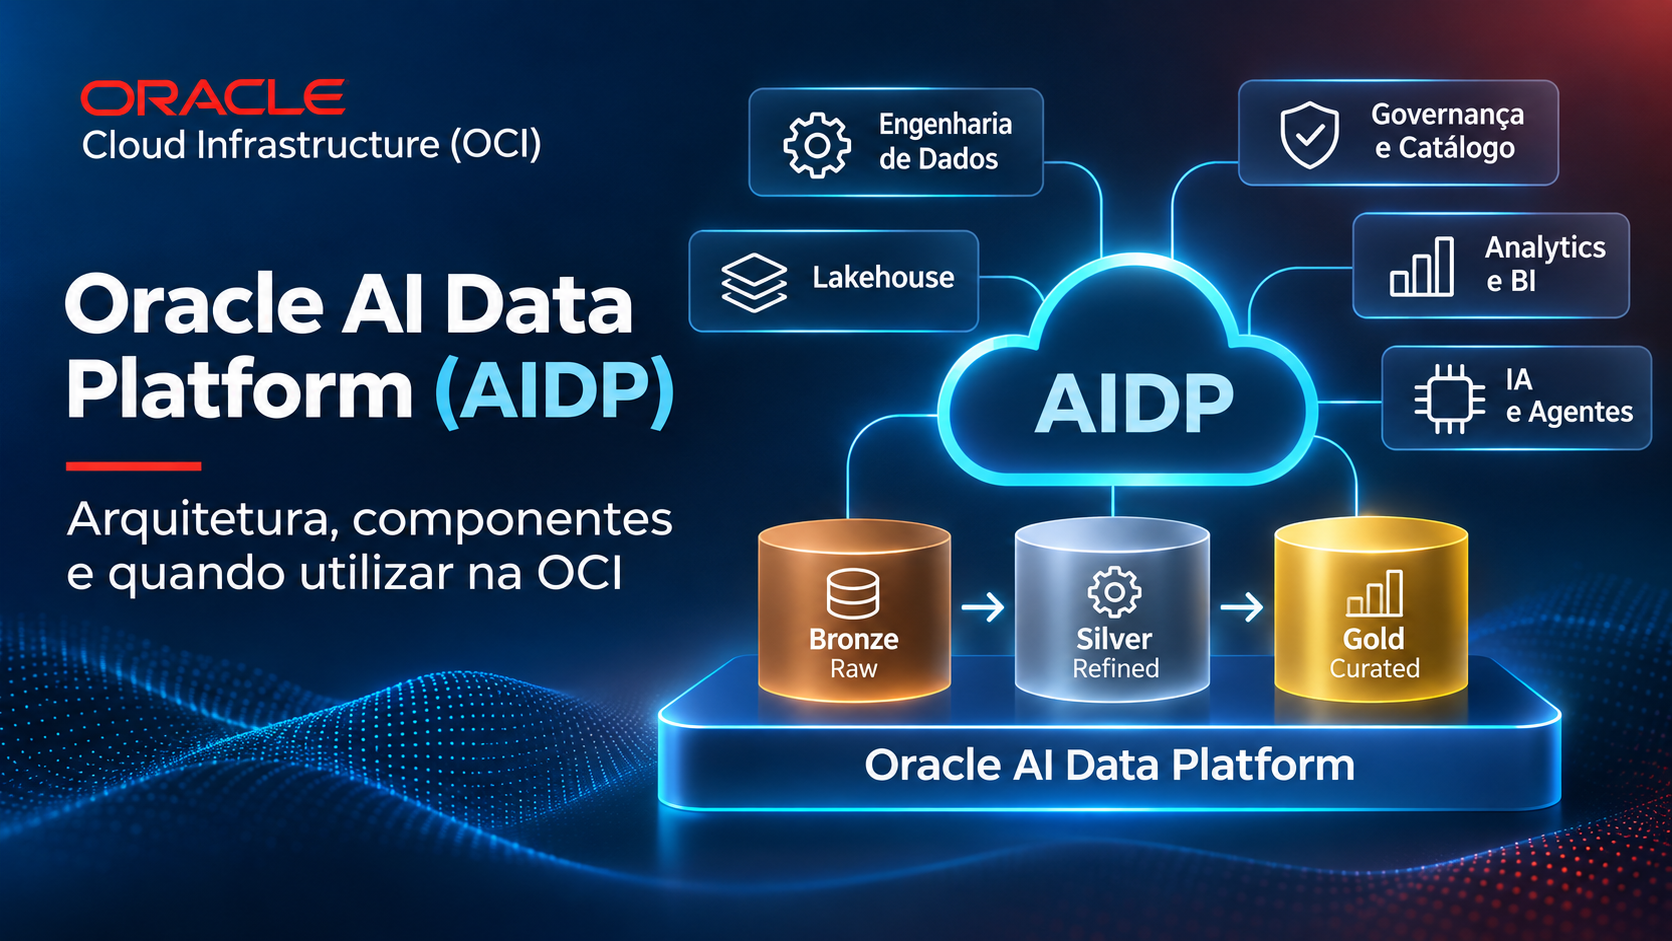
Oracle AI Data Platform (AIDP): arquitetura, componentes e quando utilizar na OCI
O desafio das arquiteturas modernas de dados deixou de ser apenas armazenar informações. Hoje precisamos integrar bancos transacionais, APIs, eventos, arquivos e aplicações SaaS, aplicar governança e disponibilizar dados confiáveis para BI, Analytics e Inteligência Artificial.
O Oracle AI Data Platform (AIDP) reúne capacidades de engenharia de dados, processamento distribuído, catálogo, Lakehouse e IA no ecossistema Oracle Cloud Infrastructure (OCI). Mas ele não deve ser confundido com um Data Warehouse tradicional — nem adotado automaticamente em todos os projetos.
Neste artigo vamos entender o que é, como funciona, por que utilizar, quando faz sentido e como compará-lo com outras alternativas.
1. O que é o AIDP?
O Oracle AI Data Platform é uma plataforma integrada para desenvolver e operar workloads de dados e IA. Ele articula ferramentas e mecanismos distintos, como Workbench, Apache Spark, Master Catalog e integração com o Autonomous AI Lakehouse.
É importante separar:
- AIDP: ambiente integrado de desenvolvimento, processamento, catálogo, governança e aplicações de IA.
- Autonomous AI Lakehouse: capacidade analítica SQL e acesso a dados em formatos abertos.
- Autonomous AI Database: serviço gerenciado de banco de dados, com workloads transacionais, analíticos e de IA.
O AIDP não é apenas um novo nome para o Autonomous Data Warehouse.
2. Arquitetura interna: como os componentes se relacionam
O primeiro diagrama representa os componentes lógicos da solução. As conexões são integrações, não uma sequência obrigatória de execução.
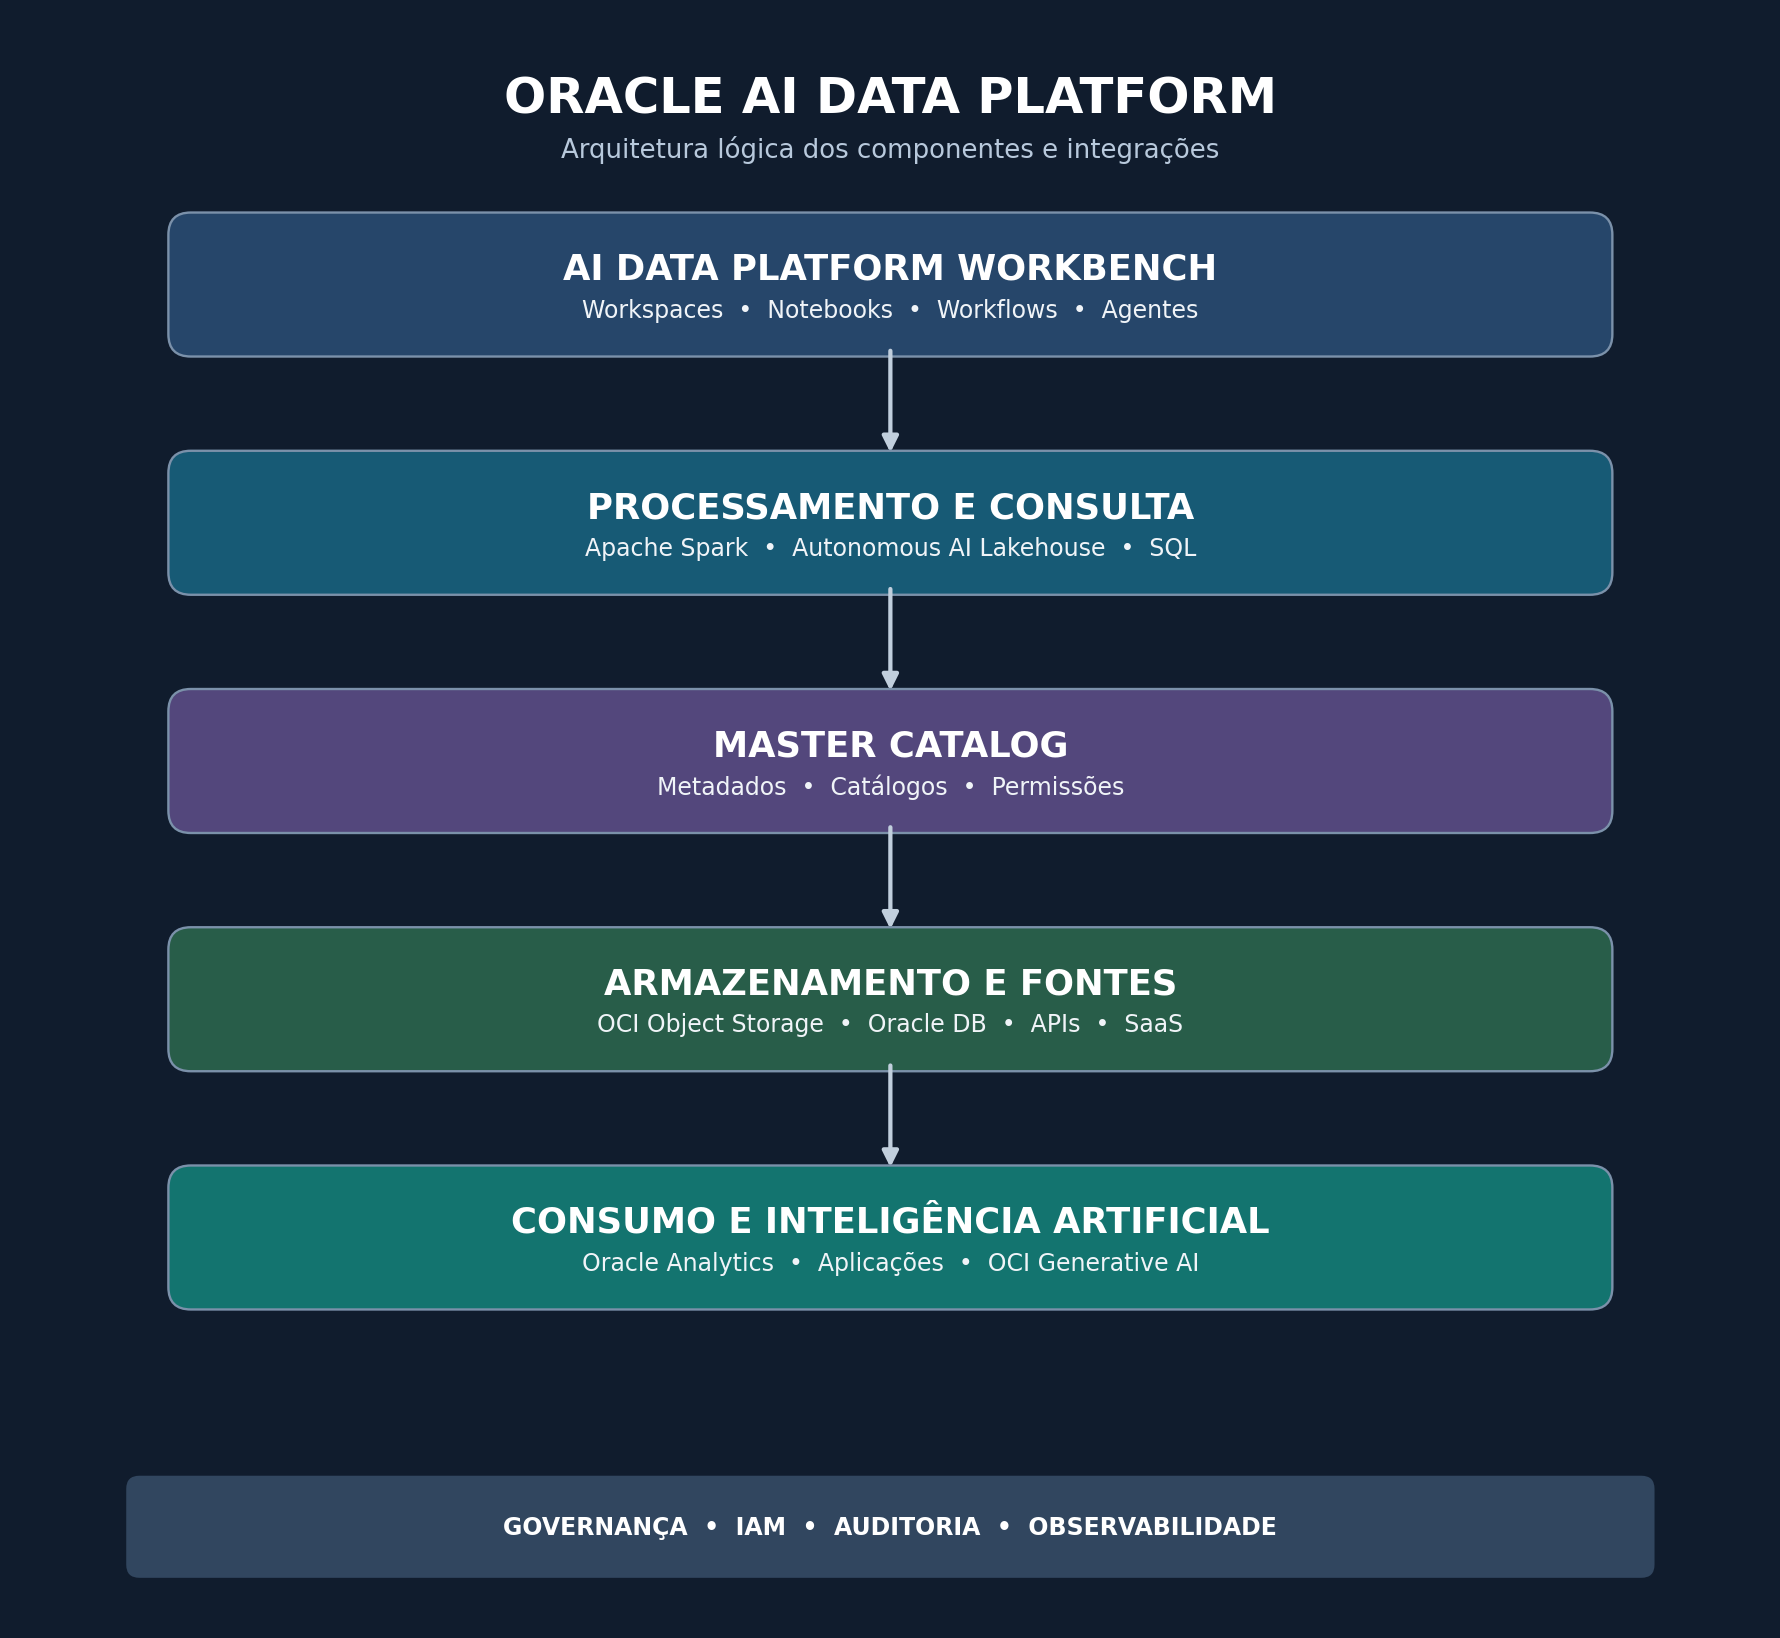
Figura 1 — Arquitetura lógica do AIDP: Workbench, mecanismos de processamento, catálogo, armazenamento e integrações. As conexões não representam uma ordem obrigatória de execução.
Workbench
O AI Data Platform Workbench organiza ambientes de desenvolvimento, notebooks, workflows e recursos de dados e IA. Permite estruturar atividades de engenharia e colaboração sem depender de uma coleção desconectada de ferramentas.
Apache Spark
O Spark executa processamento distribuído, transformações, limpeza e enriquecimento. É particularmente útil quando os dados e as operações justificam computação paralela.
Autonomous AI Lakehouse
O Autonomous AI Lakehouse atende processamento analítico SQL e cenários de integração com dados em formatos abertos, incluindo Apache Iceberg. Dependendo da implementação, dados podem ser consultados sem a necessidade de materializar todos os conjuntos em tabelas internas.
Master Catalog
O catálogo organiza ativos e metadados e participa dos controles de acesso aos objetos gerenciados. Catálogo não é sinônimo de segurança automática em todas as fontes: políticas IAM, credenciais, permissões e auditoria dos serviços subjacentes continuam necessárias.
Object Storage, fontes e consumo
O OCI Object Storage pode armazenar arquivos brutos e refinados. Bancos de dados, APIs e eventos alimentam a plataforma por diferentes estratégias. Oracle Analytics e aplicações de IA podem consumir os resultados, conforme as integrações e os controles de acesso definidos.
3. Fluxo de dados: Bronze, Silver e Gold
A arquitetura Medallion é um padrão de organização dos dados por níveis de refinamento. Não é uma obrigação de que cada camada tenha um serviço OCI próprio.
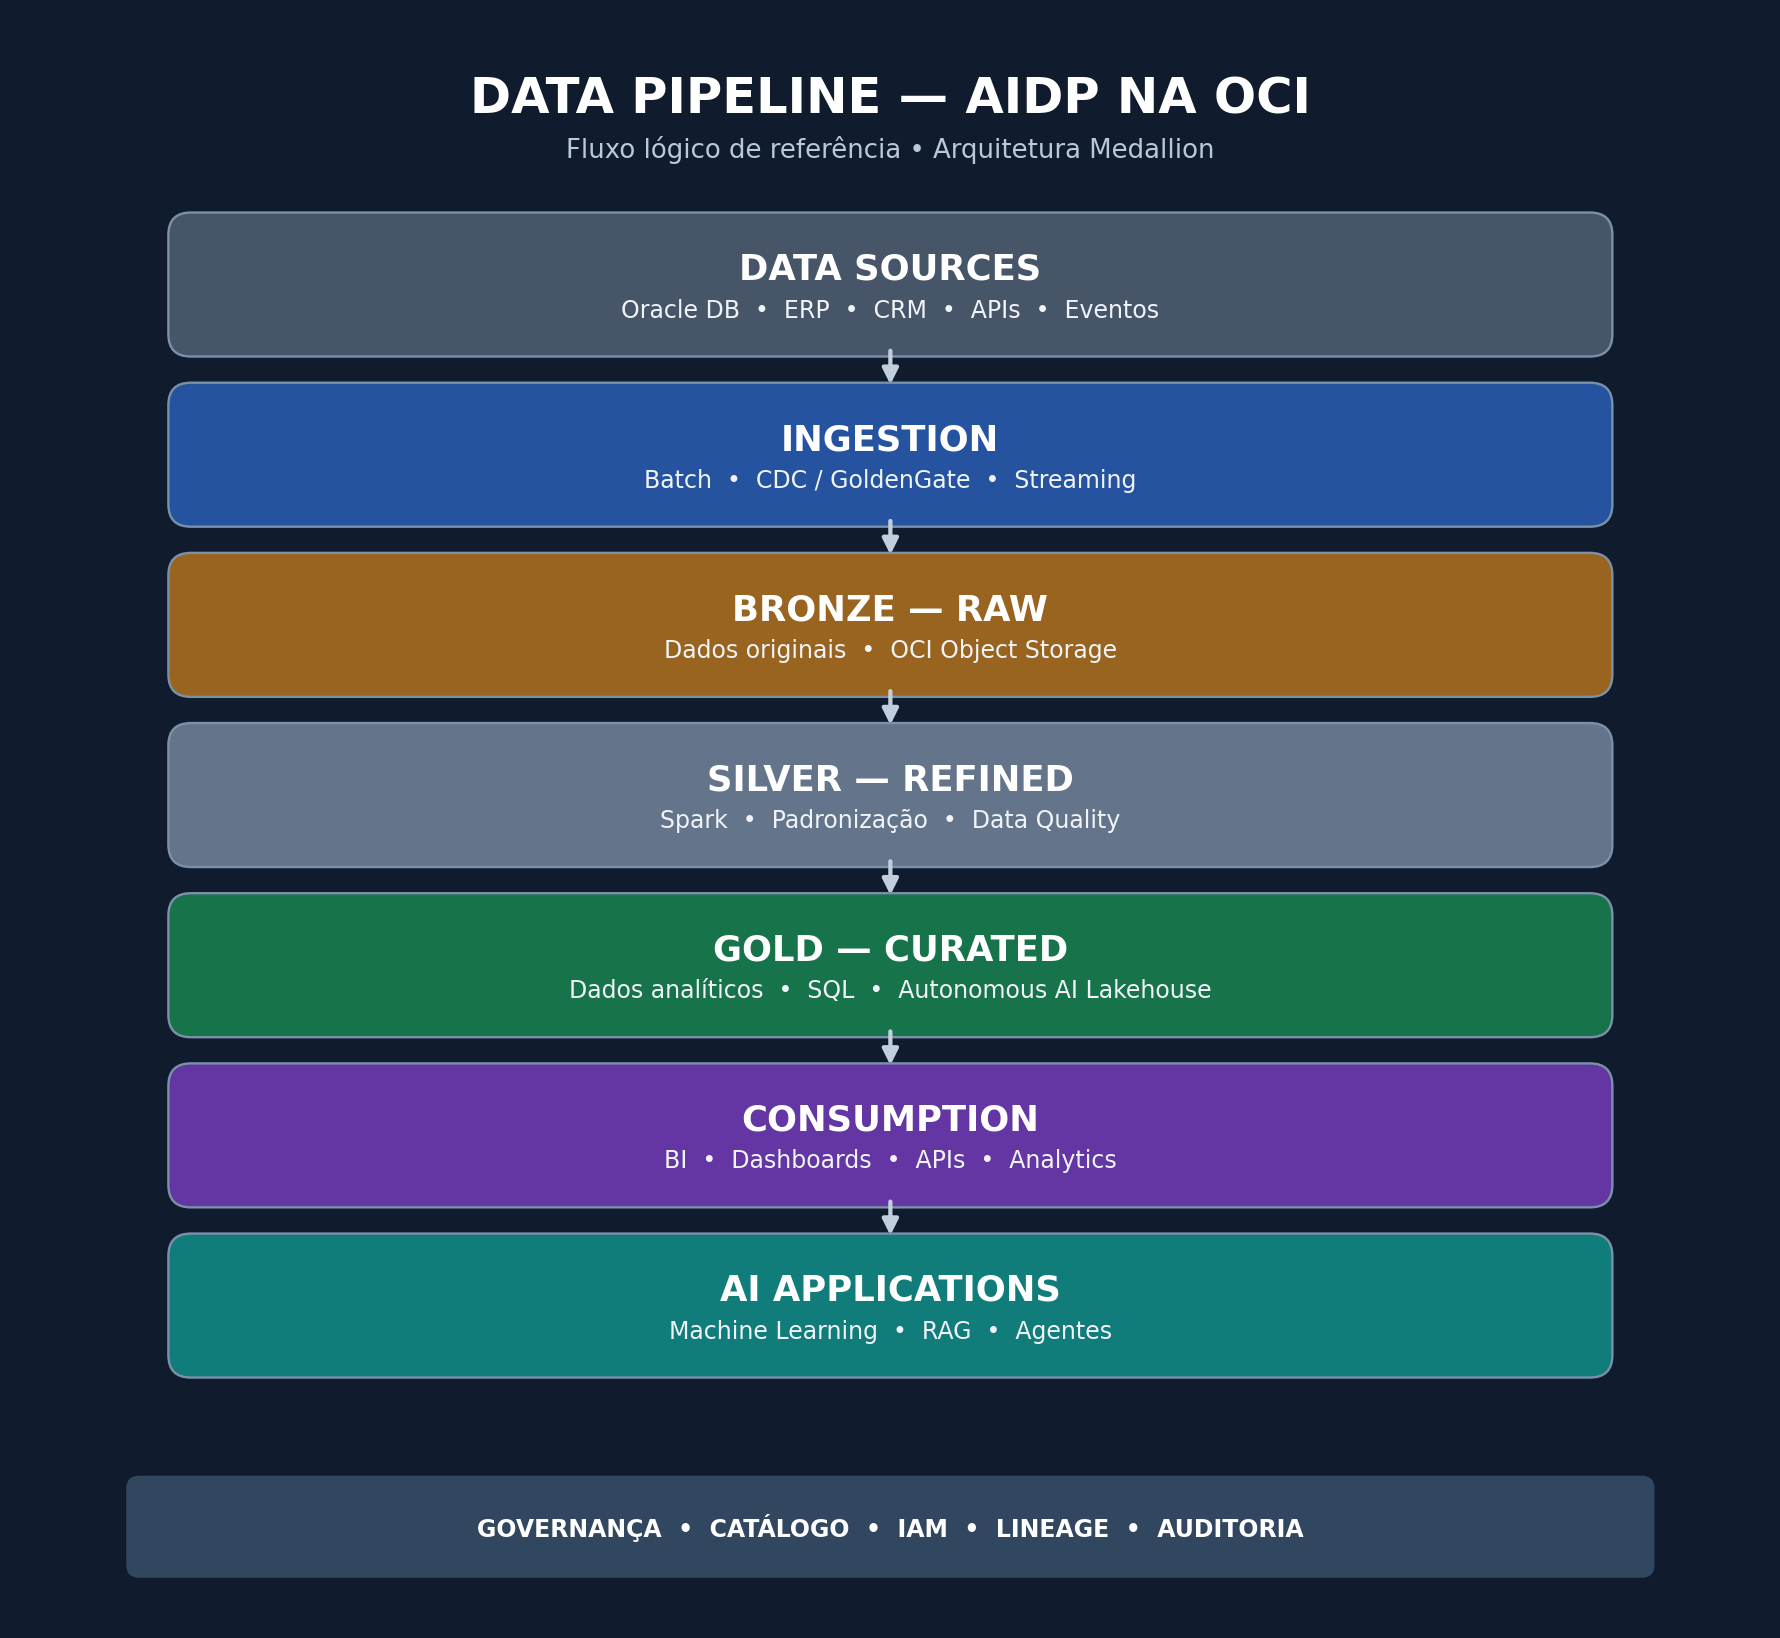
Figura 2 — Exemplo de pipeline Medallion: ingestão, armazenamento Bronze, refinamento Silver, disponibilização Gold e consumo por Analytics e IA. Governança e segurança são transversais.
Bronze: recebe os dados com pouca transformação, preservando histórico para auditoria e reprocessamento, conforme a retenção definida.
Silver: aplica validações, deduplicação, padronização, integração e regras de qualidade. Spark pode executar essas transformações, mas nem toda transformação precisa de Spark.
Gold: disponibiliza dados preparados para o negócio, como fatos, dimensões, agregações e produtos analíticos. Pode utilizar tabelas relacionais ou formatos abertos conforme os requisitos.
Atenção: Medallion e modelagem dimensional não são concorrentes. Bronze/Silver/Gold descrevem o refinamento; fatos e dimensões descrevem a organização para análise.
4. Exemplo prático: consolidando dados corporativos
Imagine uma instituição financeira com Oracle Database em sistemas transacionais, APIs de serviços digitais e eventos de aplicações.
Uma arquitetura possível seria:
- Capturar alterações com Oracle GoldenGate quando CDC for necessário.
- Receber eventos via streaming quando a latência justificar.
- Armazenar os dados brutos no OCI Object Storage.
- Executar pipelines Spark para validação, deduplicação e enriquecimento.
- Publicar conjuntos analíticos no Autonomous AI Lakehouse.
- Expor indicadores por ferramentas de Analytics.
- Permitir que aplicações de IA consultem dados autorizados e governados.
A arquitetura separa cargas analíticas de sistemas transacionais, mas não elimina a necessidade de definir consistência, retenção, LGPD, RPO, RTO, auditoria e controle de custos.
4.1. Exemplo de transformação Silver com PySpark
Considere um conjunto de arquivos Parquet já disponibilizados em um armazenamento acessível ao ambiente Spark. Queremos eliminar registros sem identificador, padronizar tipos e produzir um conjunto refinado. O exemplo abaixo é didático, não um notebook executado ou validado em um tenant AIDP.
from pyspark.sql import functions as F

# Caminhos ilustrativos: configurar acesso e credenciais no ambiente real
bronze_path = "oci://meu-bucket@meu-namespace/bronze/vendas/"
silver_path = "oci://meu-bucket@meu-namespace/silver/vendas/"

vendas = spark.read.parquet(bronze_path)

silver = (
    vendas
    .filter(F.col("pedido_id").isNotNull())
    .withColumn("data_pedido", F.to_date("data_pedido"))
    .withColumn("valor_total", F.col("valor_total").cast("decimal(18,2)"))
    .dropDuplicates(["pedido_id"])
)

silver.write.mode("overwrite").parquet(silver_path)
Esse exemplo demonstra uma transformação simples. Em produção, não devemos presumir que o último registro de um pedido é o correto: deduplicação por chave exige critérios explícitos de ordenação, versionamento e tratamento de eventos tardios. Também é necessário avaliar escrita incremental, particionamento, testes de qualidade, idempotência e políticas de reprocessamento.
O uso do esquema oci:// pressupõe conectores e configurações compatíveis com o runtime Spark. O caminho, as permissões e o método de autenticação precisam ser ajustados ao ambiente.
4.2. Publicação e consulta da camada Gold
Depois do refinamento, os dados podem alimentar um conjunto analítico no Autonomous AI Lakehouse. O mecanismo de publicação depende de como o dado foi disponibilizado: tabela interna, tabela externa ou formato aberto suportado.
Considere uma tabela analítica FATO_VENDAS já criada e carregada. Uma consulta SQL de exemplo seria:
SELECT
    TRUNC(data_pedido, 'MM') AS mes,
    COUNT(DISTINCT pedido_id) AS quantidade_pedidos,
    SUM(valor_total) AS receita_total
FROM fato_vendas
WHERE data_pedido >= ADD_MONTHS(TRUNC(SYSDATE, 'MM'), -3)
GROUP BY TRUNC(data_pedido, 'MM')
ORDER BY mes;
A consulta é SQL ilustrativo para um conjunto de dados previamente preparado; não demonstra, por si só, a criação de uma tabela Iceberg ou a conexão entre Spark e Autonomous AI Lakehouse. Esses passos dependem das configurações e interfaces disponíveis na implantação.
4.3. Como validar o pipeline
Além de verificar se o job terminou, a equipe deve acompanhar volume de entrada e saída, registros rejeitados, regras de qualidade, duração, custo de execução e possibilidade de reprocessamento. Na camada Gold, também é importante conciliar métricas com a origem e validar se os indicadores possuem definições consistentes.
5. Por que utilizar o AIDP?
O principal motivo é integrar capacidades de dados e IA que, em uma arquitetura fragmentada, exigiriam várias ferramentas e integrações operacionais.
Os ganhos potenciais incluem organização do desenvolvimento, reutilização de ativos, catálogo compartilhado, orquestração e integração entre processamento Spark, SQL e aplicações inteligentes.
Esses benefícios precisam ser comprovados no contexto do projeto. Uma plataforma integrada não garante automaticamente menor custo, maior desempenho ou menor complexidade.
6. Quando utilizar — e quando não utilizar?
O AIDP merece avaliação quando existem muitas fontes, diferentes domínios de dados, pipelines complexos, múltiplas equipes, requisitos de governança e projetos concretos de IA.
Uma solução menor pode ser melhor quando o projeto se limita a relatórios SQL sobre um banco Oracle ou a poucos pipelines ETL. Nesse caso, Autonomous AI Database, OCI Data Integration ou OCI Data Flow podem atender com menos componentes.
Cenário intermediário: se hoje existem poucos pipelines, mas a plataforma deverá crescer, compare o custo de iniciar com serviços individuais com o esforço de evoluir posteriormente para um ambiente integrado.
7. AIDP versus outros serviços OCI
| Recurso | Função principal | Quando considerar |
|---|---|---|
| Oracle AI Data Platform | Plataforma integrada de dados e IA | Múltiplos workloads, equipes e governança |
| Autonomous AI Database | Banco de dados gerenciado | SQL, Data Warehouse e aplicações |
| Autonomous AI Lakehouse | Analytics SQL e integração com formatos abertos | Consultas sobre dados relacionais e Lakehouse |
| OCI Data Integration | Integração ETL/ELT | Pipelines de integração |
| OCI Data Flow | Execução gerenciada de Spark | Jobs Spark independentes |
| OCI Object Storage | Armazenamento de objetos | Data Lakes e arquivos |
| Oracle Analytics Cloud | BI e visualização | Dashboards e relatórios |
Esses recursos não são necessariamente concorrentes: vários podem participar de uma arquitetura AIDP.
8. AIDP versus Databricks, Snowflake e Microsoft Fabric
| Critério | Oracle AIDP | Databricks | Snowflake | Microsoft Fabric |
|---|---|---|---|---|
| Engenharia de dados | Spark e SQL | Spark e SQL | SQL e pipelines | Spark, SQL e Data Factory |
| Lakehouse | Autonomous AI Lakehouse e formatos abertos | Delta Lake | Tabelas gerenciadas e formatos abertos | OneLake e Delta Lake |
| Analytics | SQL e integrações de BI | Databricks SQL e BI | SQL e BI | Power BI integrado |
| IA/ML | Recursos Oracle e OCI | MLflow e Mosaic AI | Cortex e ML | IA e integração Azure |
| Ecossistema | OCI e Oracle | Multicloud | Multicloud | Azure e Microsoft |
Esta tabela mostra posicionamento e capacidades gerais, não um benchmark. A escolha depende da arquitetura existente, experiência da equipe, integrações, segurança, portabilidade e custo total de propriedade.
9. Como decidir: critérios para uma prova de conceito
Antes de recomendar o AIDP, avalie:
- Fontes: quantos bancos, APIs, sistemas SaaS e eventos precisam ser integrados?
- Volume: quanto será armazenado e qual o crescimento esperado?
- Latência: batch, quase tempo real ou streaming?
- Processamento: predomina SQL, Spark ou ambos?
- Governança: quais controles de catálogo, linhagem, IAM, auditoria e LGPD são exigidos?
- Consumo: dashboards, aplicações, ML, RAG ou agentes?
- Operação: a equipe domina os componentes e consegue monitorá-los?
- Custos: qual o TCO de armazenamento, computação, serviços, rede e sustentação?
- Evolução: a arquitetura permite crescer sem redesenho excessivo?
Uma prova de conceito deve utilizar os mesmos dados e workloads para comparar as alternativas. Meça duração dos pipelines, latência SQL, concorrência, custo por execução, recuperação após falhas e esforço operacional.
Também confirme disponibilidade regional, pré-requisitos e versões suportadas dos serviços OCI.
9.1. Quais componentes geram custos?
Não existe um único valor universal para uma arquitetura AIDP. O custo depende da região, da modalidade contratada, dos serviços efetivamente provisionados e do padrão de consumo.
| Componente | Principal fator de custo | O que medir |
|---|---|---|
| Object Storage | Volume armazenado, operações e movimentação aplicável | GB-mês, requisições, retenção |
| Processamento Spark | Recursos de computação e duração dos jobs | Horas de execução, paralelismo, ociosidade |
| Autonomous AI Database / Lakehouse | Configuração e consumo do serviço de banco | Capacidade, tempo de uso, armazenamento |
| Integração e CDC | Serviço e modalidade de licenciamento/consumo | Volume, conectores, execução, licenças |
| Analytics | Capacidade e modalidade de contratação | Usuários, capacidade, utilização |
| IA generativa | Modelo, modalidade e volume de inferência | Requisições, tokens ou métricas do serviço |
| Operação | Engenharia, suporte e governança | Horas de equipe, incidentes, manutenção |
A tabela indica direcionadores de custo, não preços ou unidades oficiais de cobrança de cada serviço. Confirme as métricas vigentes no catálogo e na calculadora de preços da Oracle.
Uma forma prática de comparar arquiteturas é usar a mesma janela de observação e calcular:
TCO mensal estimado = armazenamento + processamento + banco analítico + integração + consumo/IA + rede aplicável + operação.
Na prova de conceito, execute os mesmos pipelines e consultas em alternativas equivalentes. Compare também custo por execução, custo por TB processado, latência e esforço de manutenção. Sem medições reais, afirmar que o AIDP é mais barato ou mais caro seria especulativo.
9.2. Limitações e pontos de atenção
Disponibilidade regional e versões. Nem todo recurso ou integração está disponível em todas as regiões e versões. Valide os pré-requisitos na documentação e no tenant OCI.
Dependências de componentes. Workbench, catálogo, processamento e mecanismos SQL não são um único serviço monolítico. Verifique o que precisa ser provisionado, configurado e operado.
Segurança e governança. IAM, permissões de origem, credenciais, auditoria, classificação e políticas LGPD devem ser avaliados de ponta a ponta. Um catálogo central não elimina controles nos serviços subjacentes.
Interoperabilidade. O suporte a formatos abertos não garante portabilidade integral de pipelines, políticas de acesso, metadados ou orquestrações. Teste migração e leitura por outras ferramentas.
Latência e desempenho. Acesso a dados externos pode evitar cópias, mas nem sempre oferece o melhor desempenho. Avalie particionamento, formatos, volume, concorrência e movimentação.
Complexidade operacional. A integração da plataforma pode simplificar alguns fluxos e introduzir novas dependências. Dimensionamento, observabilidade, recuperação e capacitação continuam necessários.
10. Conclusão
O Oracle AI Data Platform oferece uma abordagem integrada para arquiteturas modernas de dados e IA na OCI, conectando engenharia de dados, Lakehouse, governança e consumo analítico.
Mas ele não substitui a análise arquitetural. Para alguns projetos, Autonomous AI Database e Analytics são suficientes. Para outros, Data Integration ou Data Flow resolvem necessidades específicas. Em ambientes maiores e mais heterogêneos, o AIDP pode trazer ganhos relevantes de integração e governança.
A melhor arquitetura não é aquela que reúne mais tecnologias. É a que atende aos requisitos do negócio com qualidade, segurança, desempenho, capacidade de evolução e custos sustentáveis.
Referências oficiais
- Oracle AI Data Platform — Visão geral
- Oracle AI Data Platform — Documentação
- Oracle AI Data Platform Workbench
- Oracle AI Data Platform Lakehouse
- Oracle Autonomous AI Database
- Oracle Cloud Pricing
Arquiteturas e códigos ilustrativos, não validados em um tenant específico. Os recursos disponíveis, pré-requisitos e custos devem ser confirmados na documentação oficial para a região e versão utilizadas.
Comments
Join the discussionNo comments yet. Be the first to comment.